-84.2%
手動文書校正と比較した平均処理サイクル時間の短縮幅。
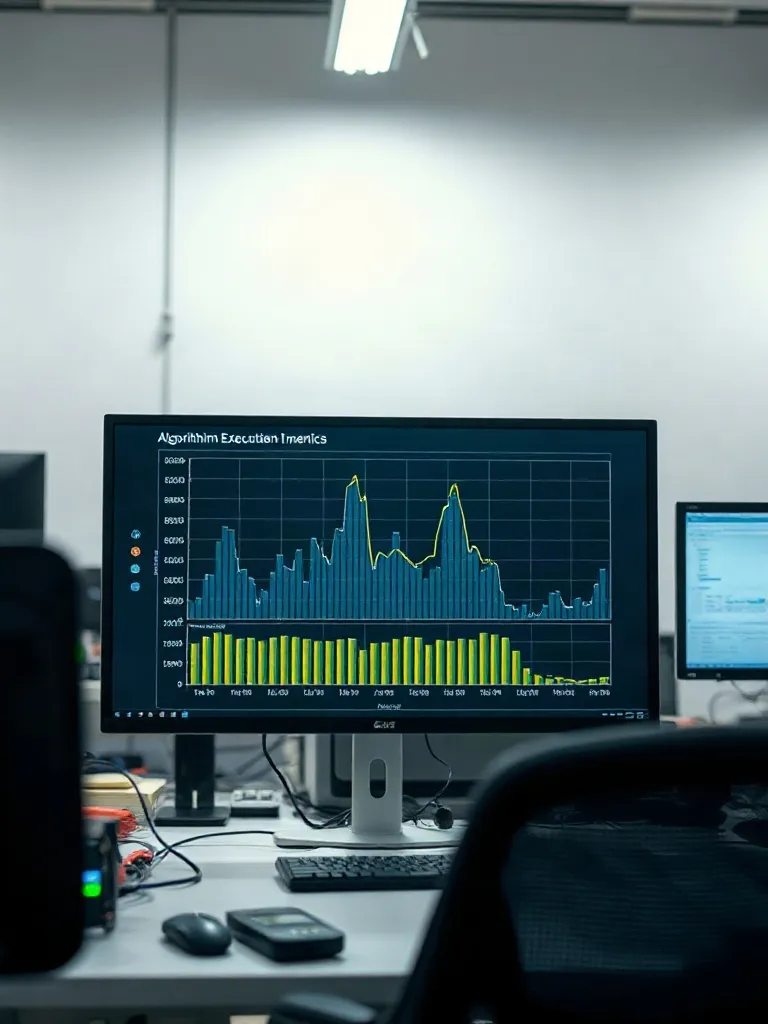
推論エンジンと自動化スクリプトの連携におけるスループット、遅延時間、およびトークン消費効率を数値化。反復タスクの負荷を最小化する計算プロセスを公開します。
手動文書校正と比較した平均処理サイクル時間の短縮幅。
構造化JSON出力検証における文法および型エラーの非発生率。
並列ワーカー環境における1分あたりの処理可能トランザクション数。
スプレッドシートAPIエンドポイントへのパケット往復遅延時間中央値。
機械処理の反復単位ごとに時間定数を分解し、ボトルネックとなるI/O待機時間を特定しました。音声文字起こしから文書構文木への展開処理は、非同期ワーカーによって直列負荷を分散しています。
60分の会議音声データは、分割推論モデルにより平均114秒で構文解析されます。議事録自動生成プロトコルと連携することで、話者分離と要約トークンの生成を同一パイプライン上で実行可能です。
プレーンテキストから階層化スライドデータへの変換は、構文解析バッファの最適化により1ページあたり1.4秒で収束します。資料作成パイプラインを介して、出力フォーマットを厳密に制限しています。
推論タスクごとのリソース消費量および応答速度の実測値です。高精度モデルと軽量モデルをタスクの性質に応じて割り振ることで、演算コストと実行遅延を抑制します。
複雑な多段階推論および非構造化データからの特定スキーマ抽出に割り当てられます。
短文のフィルタリング、エンティティ分類、リアルタイムテキスト補正を実行するエンジンです。
外部ネットワーク遮断環境下での正規表現生成および表データ前処理を担当します。
ローカル環境でのバッチ実行時におけるVRAM消費量は最大3.8GBに制限され、バックグラウンド処理時のCPU占有率は12%未満を維持します。リソース競合を防止する優先度キューにより、メインスレッドの動作を妨げません。
また、APIリクエストレートは動的トークンバケットアルゴリズムで制御され、超過呼び出しによるエラーをゼロに抑えています。